前回の記事で gRPC とは何か、どう使うかを説明し、最後に「可読性を犠牲にして性能を得るこの仕組みが、実際どれだけの効果をもたらすのか」を検証すると書きました。今回はその実測記録です。
コードは別リポジトリに置いています:Clark1945/java の grpc_test ディレクトリ。主なファイルは以下の通りです。
- gRPC サーバー側:
OrderServiceImpl.java、SensorServiceImpl.java - REST 対照群:
HttpBenchmarkServer.java、HttpBenchmarkClient.java - ベンチマーク本体:
StreamingVsHttpBenchmark.java
テスト設計
今回は「大量データの一括転送」というシナリオに絞り、2つの対照群で比較しました。
| シナリオ | gRPC の RPC | REST 対照群 |
|---|---|---|
| アップロード集約(client streaming) | SensorService.ReportReadingsBatched | POST /sensor-readings(JSON 配列を一括送信) |
| バッチダウンロード(server streaming) | OrderService.ListOrdersBatched | GET /orders(JSON 配列を一括取得) |
その他の設定:
- レコード件数:1,000 / 10,000 / 100,000 / 500,000 / 1,000,000
- 1レコードあたりのフィールド数:8個(
SensorReadingは device_id、value、timestamp、unit、location、battery_level、status、firmware_version。OrderResponseは order_id、amount、currency、status、created_at、customer_id、item_count、shipping_address) - gRPC のバッチサイズ:1つの stream message あたり1,000件
- テスト環境:ローカルの loopback(同一マシン、gRPC サーバーは 9091 番ポート、HTTP サーバーは 8081 番ポートで待受)、JVM 起動時に
-Xmx3gを指定
実測結果
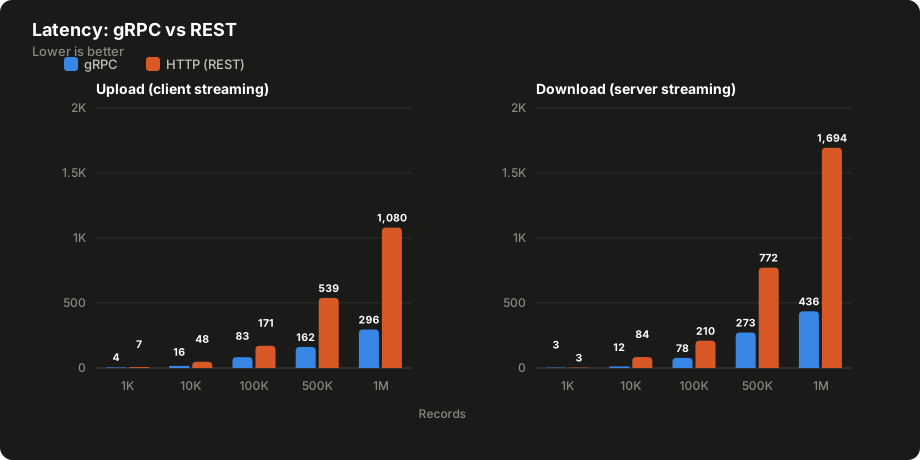
アップロード集約(client streaming)とバッチダウンロード(server streaming)の両シナリオで、1,000件から1,000,000件までのレイテンシ(ms)を計測しました。
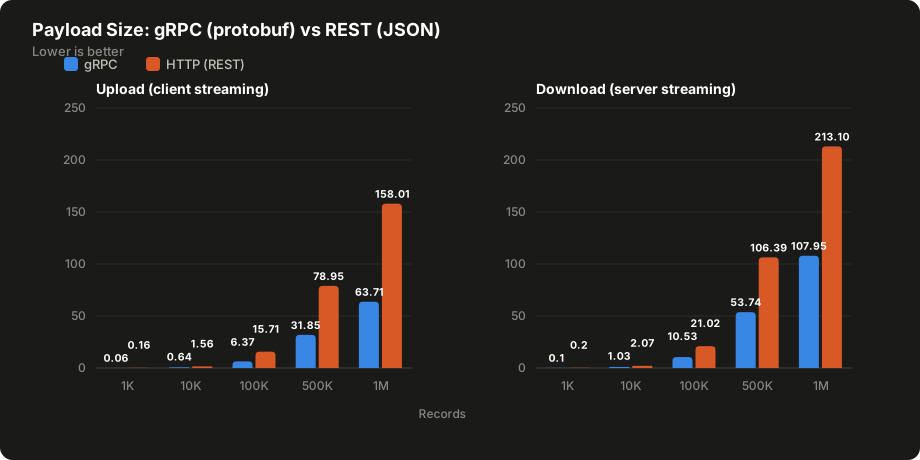
同じシナリオでの転送量(MB)比較です。protobuf でシリアライズしたサイズは、JSON よりも一貫して小さくなっています。
観察と結論
バッチ化した gRPC streaming は REST を全面的に上回っており、件数が増えるほど差は広がります。100万件時点では、アップロードの所要時間は3.6倍(296ms vs 1,080ms)、ダウンロードは3.9倍(436ms vs 1,694ms)の差がついています。
転送量の差が性能差の主な原因の一つです。同じ8フィールド、同じ件数でも、protobuf でシリアライズしたサイズは JSON の40%〜50%程度に収まります(100万件のダウンロードで gRPC 108MB vs HTTP 213MB)。理由は単純で、JSON は1レコードごとにフィールド名("shippingAddress" など)をキーとして毎回書き出す必要がありますが、protobuf のフィールドタグはたった1〜2バイトの数値だけです。これが大量のレコードで積み重なると、かなり大きな差になります。
streaming の性能上の優位性は、「メッセージごとの固定コストを均す」ことで成り立っています。1件ずつ送る方式(1レコード=1メッセージ)は少量では大きな差が出ませんが、データ量が増えると、メッセージごとのフレーミング・シリアライズ・スケジューリングのオーバーヘッドが急速に積み重なり、今回の実測のようにメモリを直接溢れさせてしまうこともあります。これは gRPC の flow control の仕組みが存在する理由を裏付けるものでもあり、naive な使い方を本番環境に持ち込むのは本当に危険だということです。
なお、この結果はローカルの loopback で計測したものです。実際のネットワーク環境(実際の遅延や帯域制限がある環境)では、gRPC の相対的な優位性はさらに顕著になると予想されます(protobuf のサイズが小さい=転送時間が短い)が、具体的に何倍になるかは実際のネットワーク環境で改めて検証する必要があります。
失敗談:1件ずつ送ってメモリを溢れさせた話
最初のバージョンでは、クライアント側で1レコードごとに onNext() を呼び出していました。バッチ化もせず、flow control のチェックも一切していません。実測してみると、この方式はデータ量が大きくなると性能がバッチ送信より大きく劣ることが分かりました。50万件時点で、1件ずつ送るバージョンは6,000ms以上かかったのに対し、バッチ送信は100ms台でした。
100万件まで増やすと、さらに派手なことになりました。1件ずつ送るバージョンは gRPC-netty の direct memory buffer を完全に使い果たし、次のエラーを吐きました。
OutOfMemoryError: Cannot reserve 2097152 bytes of direct buffer memory原因は、クライアント側が async stub で onNext() を連打しながら、isReady()(つまり flow control)を一度もチェックしていなかったことです。メッセージの生成速度がネットワークの処理速度を大きく上回り、Netty の outbound buffer がひたすら積み上がってメモリ上限に達してしまいました。
考えてみれば当然で、大量データのシナリオで本当に1件ずつ送る人などいません。実務で使える書き方ではそもそもないのです。そのため、最終的なベンチマークでは「バッチ streaming vs REST の一括送信」という、本当に意味のある対照だけを残し、1件ずつ送るバージョンはベンチマークから除外しました(ただし、両方の RPC の1件送信版のメソッド自体は、小規模データ向けの基本的な教材サンプルとして SensorServiceImpl / OrderServiceImpl に残してあります)。
既知の制限
- テストは同一マシン上の loopback ネットワークで行っており、実際のネットワーク遅延や帯域制限はシミュレートしていません。
- 実行は1回のみ(ウォームアップ1回を含む)で、複数回の平均を取った厳密なベンチマークではありません。数字は参考程度であり、精確な基準ではありません。
- REST 対照群は JDK 標準の
com.sun.net.httpserver.HttpServerと Jackson を使用しており、Spring MVC のような本番用フレームワークは使っていないため、実際のフレームワークが持つオーバーヘッドは含まれていません。
再現方法
cd grpc_test
mvn compile
mvn dependency:build-classpath -Dmdep.outputFile=cp.txt
java -Xmx3g -cp "target/classes;$(cat cp.txt)" com.example.benchmark.StreamingVsHttpBenchmark
さて、今回の一連のテストで、大量データのシナリオにおける gRPC の性能上の優位性について具体的な数字のイメージが掴めたと思います。同時に、flow control をきちんと実装しないとどれほど悲惨なことになるかも、身をもって学びました。
今回の記事はここまでです。それでは、また巡り会える日まで。