上一篇講完了 gRPC 是什麼、怎麼用之後,結尾我說要接著進測試,測測看這種「犧牲可讀性換取效能」的做法,到底能換到多少優勢。這篇就是實測紀錄。
程式碼放在另一個 repo:Clark1945/java 的 grpc_test 目錄,主要檔案:
- gRPC 服務端:
OrderServiceImpl.java、SensorServiceImpl.java - REST 對照組:
HttpBenchmarkServer.java、HttpBenchmarkClient.java - Benchmark 主程式:
StreamingVsHttpBenchmark.java
測試情境設計
這次鎖定「大資料量批次傳輸」這個情境,分兩組對照:
| 情境 | gRPC 對應 RPC | REST 對照組 |
|---|---|---|
| 上傳彙總(client streaming) | SensorService.ReportReadingsBatched | POST /sensor-readings(一次送整包 JSON 陣列) |
| 批次下載(server streaming) | OrderService.ListOrdersBatched | GET /orders(一次回整包 JSON 陣列) |
其他設定:
- 資料筆數:1,000 / 10,000 / 100,000 / 500,000 / 1,000,000
- 每筆欄位數:8 個(
SensorReading是 device_id、value、timestamp、unit、location、battery_level、status、firmware_version;OrderResponse是 order_id、amount、currency、status、created_at、customer_id、item_count、shipping_address) - gRPC 批次大小:每個 stream message 帶 1,000 筆記錄
- 測試環境:本機 loopback(同一台機器,gRPC server 監聽 9091、HTTP server 監聽 8081),JVM 啟動時給
-Xmx3g
實測結果
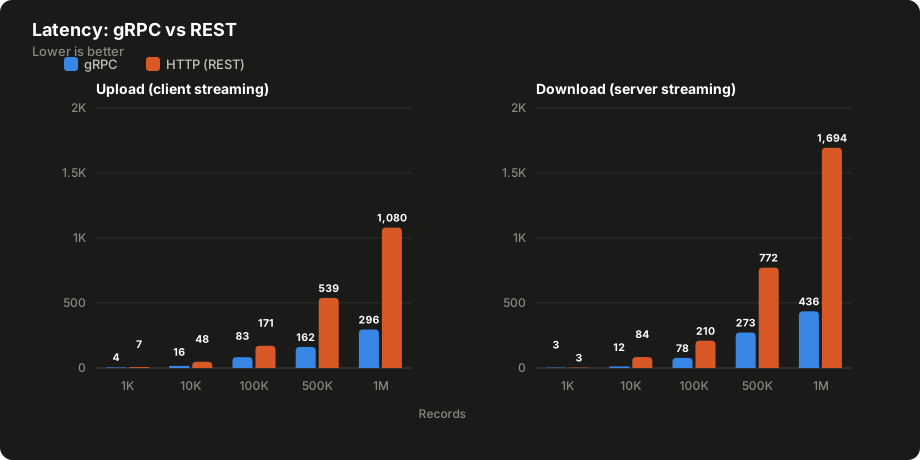
上傳彙總(client streaming)與批次下載(server streaming)兩種情境,各自在 1,000 到 1,000,000 筆資料量下量測耗時(ms):
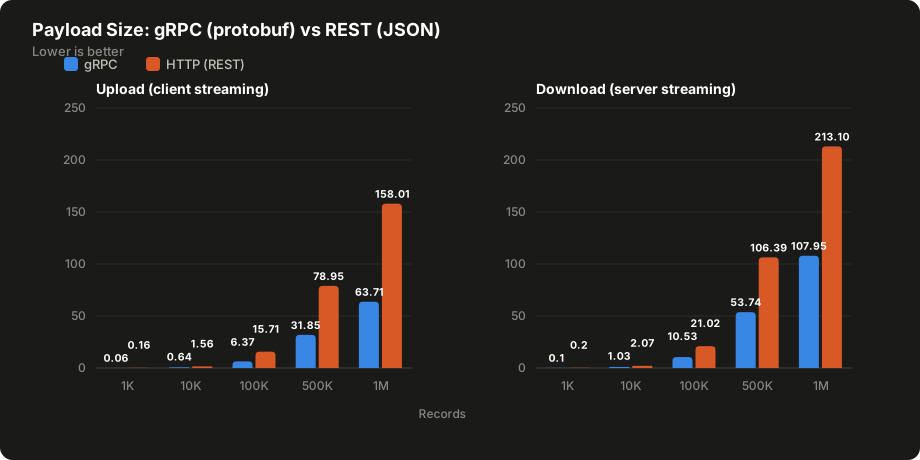
同樣情境下的傳輸量(MB)比較,protobuf 序列化後的體積穩定比 JSON 小:
觀察與結論
批次後的 gRPC streaming 全面領先 REST,而且筆數越多差距越大:100 萬筆時,上傳耗時差了 3.6 倍(296ms vs 1,080ms),下載耗時差了 3.9 倍(436ms vs 1,694ms)。
傳輸量的差距是效能差距的主因之一。同樣 8 個欄位、同樣筆數,protobuf 序列化後的體積穩定只有 JSON 的 40%-50% 左右(100 萬筆下載:gRPC 108MB vs HTTP 213MB)。原因也不難理解,JSON 每一筆記錄都要重複寫欄位名稱(像是 "shippingAddress")當 key,而 protobuf 的欄位標籤只是 1-2 個 byte 的數字,光是這點在大量重複資料下就會被放大成很可觀的差距。
streaming 的效能優勢,建立在「攤平每則訊息的固定開銷」上。逐筆送(每筆一個 message)在小量時看不太出差異,但資料量一大,每則訊息的框架、序列化、排程開銷會迅速疊加,甚至可能像我這次實測一樣直接把記憶體灌爆——這也印證了 gRPC 的 flow control 機制存在是有道理的,naive 的用法丟到生產環境是真的會出事。
要提醒的是,這個結果是在本機 loopback 測出來的,實際網路環境下(有真實延遲、頻寬限制),gRPC 的相對優勢預期會更明顯,因為 protobuf 體積更小代表傳輸時間更短,但確切能差到多少倍,還是要另外在真實網路環境驗證過才能下定論。
一個踩雷紀錄:逐筆送直接把記憶體炸了
一開始我寫的版本,是讓 client 端每一筆記錄就呼叫一次 onNext(),不打包、也沒檢查 flow control。實測發現這個寫法在資料量大的時候,效能遠差於批次送:50 萬筆時,逐筆送要 6,000ms 以上,批次送才 100ms 等級。
推到 100 萬筆的時候更誇張,逐筆送的版本直接把 gRPC-netty 的 direct memory buffer 灌爆,噴出:
OutOfMemoryError: Cannot reserve 2097152 bytes of direct buffer memory原因是 client 端用 async stub 狂打 onNext(),完全沒檢查 isReady()(也就是沒做 flow control),訊息產生的速度遠超過網路能消化的速度,Netty 的 outbound buffer 就一路累積到爆記憶體上限為止。
想想也合理,大資料量的情境下本來就不會有人真的逐筆傳送,這根本不是實務上的可用寫法。所以最終的 benchmark 只留下「批次 streaming vs REST 單一大包」這組真正有意義的對照,逐筆送的版本就從 benchmark 裡拿掉了(不過兩個 RPC 的逐筆版方法還留在 SensorServiceImpl / OrderServiceImpl 裡,當作小資料量情境下的基礎教學範例)。
已知限制
- 測試在同一台機器上的 loopback 網路完成,沒有模擬真實的網路延遲/頻寬限制。
- 只跑了一輪(含一次 warm-up),不是多輪取平均的嚴謹 benchmark,數字有參考價值但不是精確基準。
- HTTP 對照組用的是 JDK 內建
com.sun.net.httpserver.HttpServer+ Jackson,沒有用正式框架(像 Spring MVC),實際框架會帶來的額外開銷沒有算進去。
如何重現
cd grpc_test
mvn compile
mvn dependency:build-classpath -Dmdep.outputFile=cp.txt
java -Xmx3g -cp "target/classes;$(cat cp.txt)" com.example.benchmark.StreamingVsHttpBenchmark
好,這樣一輪測下來,對 gRPC 在大資料量情境下的效能優勢應該有具體的數字概念了,也順便踩到了 flow control 沒做好會有多慘烈。
那麼這次的文章就到這裡,讓我們在下一個猴年馬月再見吧。